• Densidad del arbolado de Cali con R

    Contacto: wa.me/+573217850490

    El último censo arbóreo de Cali, que la CVC le entregó al DAGMA en 2024, registró unos 382 mil individuos en la zona urbana (Alcaldía de Cali). Cuando uno pone esos puntos en un mapa, lo que ve es una mancha verde. No dice mucho. La pregunta útil es otra: ¿dónde se concentran y dónde faltan?

    Para responder eso hay dos caminos clásicos y en este tutorial hago los dos:

    • Raster de conteo. Divido la ciudad en celdas (50, 100 o 250 m) y cuento cuántos árboles caen en cada una. Es directo y fácil de explicar, pero el resultado cambia según el tamaño y la posición de la grilla.
    • Densidad kernel (KDE). A cada árbol le pongo una «campana» que reparte su peso alrededor, y sumo todas las campanas. Sale una superficie continua. Aquí lo que manda es el ancho de banda (sigma): con 150 m ves cuadras, con 600 m ves zonas de la ciudad.

    Y una aclaración que me preguntan seguido: esto no se hace con kriging. El kriging interpola una variable que existe en todo el espacio (temperatura, precipitación) a partir de muestras. La ubicación de los árboles no es una muestra de nada, es el fenómeno completo. Para eso está el análisis de patrones de puntos, y el kernel es su herramienta base.

    La preparación

    Datos. Todo sale de fuentes oficiales de la Alcaldía:

    CapaFuenteNota
    Árboles (censo arbóreo)Geovisor IDESC, descarga directa del censo (censo_arboreo_2023.rar)Capa obs_arb_censo_arboreo_20241105: 382.021 puntos, en MAGNA-SIRGAS origen Cali
    Árboles (alternativa)Datos Abiertos CaliCSV por comuna; es el censo de 2015, actualizado en 2019
    Barrios, comunas y sectores de expansiónDIVIPOLA IDESCGeodatabase del Acuerdo 0636 de 2026

    Ojo con el sur: la zona de expansión no tiene barrios adoptados. Está dividida en sectores geográficos, una capa aparte dentro de la misma geodatabase. Si solo cargas barrios, esa zona te queda en blanco. En el script uno barrios y sectores en una sola capa de unidades.

    Tipo de registro. La capa del censo tiene 382.021 puntos, pero no todos son árboles. Hay 239.014 árboles (código ARB) y 69.600 palmas (PAL). El resto son otros tipos de vegetación (ABT, GUA, BAM y CBR) o registros sin tipo (ND). Para la densidad uso solo árboles y palmas: si cuentas todo, la densidad de árboles sale inflada.

    Sistema de referencia. Trabajo en MAGNA-SIRGAS origen Cali (EPSG:6249), que está en metros. Esto no es opcional: el tamaño de celda, el sigma del kernel y las áreas tienen que estar en metros. En grados (EPSG:4326) los números no significan nada.

    Librerías. sf y terra para vector y raster, spatstat.geom y spatstat.explore para el patrón de puntos y el kernel, tidyverse para el manejo de tablas, y ggspatial y patchwork para los mapas.

    Comandos clave
    • sf::st_filter(): antes de todo, me quedo solo con árboles y palmas (ARB y PAL en el campo CaTipoVeg) que caen dentro del área urbana más la de expansión. Si hay puntos duplicados (mismas coordenadas) también los quito, porque inflan la densidad.
    • terra::rasterize(..., fun = length): es el raster de conteo. Cada celda recibe el número de árboles que caen en ella. Luego divido por el área de la celda en hectáreas para tener árboles/ha, y así puedo comparar 50, 100 y 250 m.
    • spatstat.geom::ppp(): convierte los árboles en un patrón de puntos con su «ventana», que es el límite de la ciudad. La ventana importa porque el kernel corrige el efecto de borde con ella.
    • spatstat.explore::bw.scott.iso(): da un ancho de banda de referencia rápido. Hay métodos más finos (bw.diggle, bw.ppl), pero con más de 300 mil puntos se demoran demasiado para un video.
    • spatstat.explore::density.ppp(): el kernel como tal. Le paso el sigma (150, 300 y 600 m) y el tamaño de píxel. Devuelve intensidad por m², que multiplico por 10.000 para llevarla a árboles/ha.
    • sf::st_intersects() + lengths(): el resumen por barrio y comuna. Cuento árboles por polígono y divido por su área. Es la versión «administrativa» de la densidad, la que sirve para decir qué barrio está más pelado.

    Un chequeo que siempre hago: si sumo el kernel sobre toda la ciudad (intensidad × área del píxel), me tiene que dar más o menos el número total de árboles. Si no, algo está mal con las unidades.

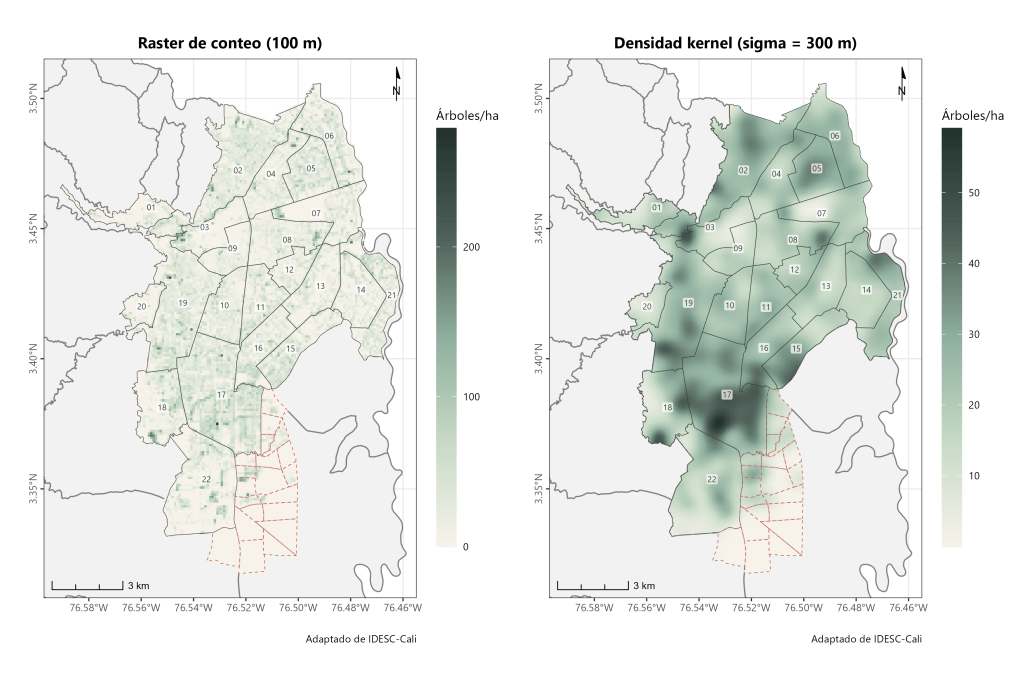
    Con ese chequeo listo, el script arma los mapas con ggspatial (escala y norte) y pone el raster de conteo y el kernel lado a lado con patchwork. Ahí se ve la diferencia: el conteo se ve «pixelado» y con huecos, el kernel suaviza y muestra los corredores verdes.
    Para cerrar

    En Cali, el arbolado se concentra en el sur, en la comuna 17, y forma núcleos en el occidente (comunas 3 y 19) y en el oriente (comunas 15 y 21). Lo más pelado está en el centro (comunas 7, 9 y 12) y en la ladera de la comuna 20. Por barrio, el que más árboles por hectárea tiene es [BARRIO], con [X] árboles/ha.

    El conteo te dice cuántos árboles hay en cada cuadro; el kernel te dice cómo se reparte el arbolado en la ciudad. Los dos sirven, pero para preguntas distintas. Y en ambos casos el resultado depende de una decisión tuya (tamaño de celda o sigma), así que siempre vale la pena mostrar más de uno.

    El paso a paso completo, con el código corriendo, está en el canal:
    Fuentes
  • En este tutorial genero códigos QR desde R para cinco fuentes de datos climáticos y geoespaciales que uso a diario. Con un vector de URLs y un bucle de pocas líneas, R escribe un PNG por enlace, listo para una presentación, un póster o una clase.

    Un QR resuelve un problema concreto: el público no puede hacer clic en una diapositiva proyectada ni en un afiche impreso. Hacerlo en R, y no en un generador web, deja el proceso reproducible y lo escala a 5 o a 500 enlaces sin repetir clics.

    Las cinco fuentes

    Cada QR apunta a un portal de datos abiertos. El nombre corto de la tercera columna es el que usa el código para nombrar cada PNG.

    FuenteQué ofreceNombre en el código
    IDEAM – DHIMESeries hidrometeorológicas de las estaciones de Colombiaideam
    SIAC – Portal de Datos Abiertos MADSCapas ambientales oficiales del Ministerio de Ambientesiac
    Copernicus Data Space EcosystemImágenes Sentinel y servicios Copernicus, de acceso librecope
    WorldClim 2.1Climatología 1970–2000 y 19 variables bioclimáticas, de 30 s a 10 minwcli
    CHIRPS v3Precipitación a 0.05°, de 1981 a casi el presentechrp

    El código

    El script completo cabe en 20 líneas y solo depende del paquete qrcode. Al correrlo, la carpeta qr/ queda con cinco archivos: qr_ideam.png, qr_siac.png, qr_cope.png, qr_wcli.png y qr_chrp.png.

    
    # Load libraries ----------------------------------------------------------
    pacman::p_load(qrcode)
    
    # URLs --------------------------------------------------------------------
    urls <- c(
      ideam = "https://www.ideam.gov.co/dhime",
      siac  = "https://siac-datosabiertos-mads.hub.arcgis.com",
      cope  = "https://dataspace.copernicus.eu/",
      wcli  = "https://worldclim.org/data/worldclim21.html",
      chrp  = "https://chc.ucsb.edu/data/chirps3"
    )
    
    # Generate QR codes -------------------------------------------------------
    dir.create("qr", showWarnings = FALSE)
    
    for (name in names(urls)) {
      code <- qr_code(urls[[name]], ecl = "M")
      png(file.path("./qr/", paste0("qr_", name, ".png")), width = 1000, height = 1000)
      par(mar = c(0, 0, 0, 0))
      plot(code)
      dev.off()
    }
    
    
    Buenas prácticas antes de imprimir

    Un QR impreso no se corrige, así que vale la pena revisar tres cosas antes de mandarlo a un afiche.

    • Escanea cada QR con el celular. Confirma que abre la página que esperas. Por ejemplo, el enlace del IDEAM abre la portada de DHIME; la descarga de datos está en atencionciudadano.ideam.gov.co.
    • Elige el nivel de corrección según el uso. "L" (7 %) o "M" (15 %) bastan para pantalla. Usa "H" (30 %) si vas a poner un logo encima con add_logo().
    • Para impresión, usa vector. El mismo paquete escribe SVG, que escala a cualquier tamaño sin pixelarse. Dentro del bucle, basta con una línea:
  • Comparto aquí el vídeo donde explico como analizar datos espaciales, tanto puntos como rasters, de los datos del sismo ocurridos el pasado 10 de agosto de 2026 en San José del Palmar.

    Sí deseas acceder a los códigos puedes visitar mi repositorio de Github: https://github.com/fabiolexcastro/tutorials_youtube/tree/main/sismos_wspce

    Si requieres asesoría o tienes preguntas me puedes contactar (whatsapp)

  • Contacto: wa.me/+573217850490

    En este nuevo vídeo tutorial de mi canal de YouTube (youtube.com/fabiocastrollanos) damos un paso más allá del mapa temático tradicional y respondemos una pregunta que difícilmente se puede contestar con una sola capa: ¿la infraestructura vial de un municipio guarda relación con la pobreza de los territorios que lo rodean?

    Para resolverlo aplicamos un análisis de Moran bivariado entre la longitud de vías y el Índice de Pobreza Multidimensional (IPM) a nivel municipal para toda Colombia, usando R. La variable de longitud de vías la construimos en un tutorial anterior, donde cuantificamos la red vial de cada municipio; aquí la ponemos a «conversar» con la pobreza.

    1. El trasfondo

    Un mapa de coropletas nos dice dónde hay valores altos o bajos de una variable. El Moran univariado da un paso más y mide si esos valores se agrupan en el espacio, es decir, si municipios «parecidos» tienden a ser vecinos. Pero en el análisis territorial la pregunta interesante casi siempre involucra dos fenómenos a la vez.

    Ahí entra el Moran bivariado. En lugar de comparar una variable consigo misma, compara el valor de una variable en un municipio con el promedio de otra variable en sus vecinos (lo que técnicamente llamamos rezago espacial). El resultado es una clasificación local (LISA) que ubica a cada municipio en uno de cuatro cuadrantes:

    • Alto – Alto: municipios con alta longitud de vías rodeados de vecinos con alta pobreza.
    • Bajo – Bajo: poca vía, rodeada de vecinos con baja pobreza.
    • Alto – Bajo: buena dotación vial en un entorno de baja pobreza.
    • Bajo – Alto: poca infraestructura vial inmersa en un entorno de alta pobreza.

    Este último cuadrante, el «Bajo – Alto», suele ser el más relevante para la política pública: señala bolsones de pobreza con conectividad deficiente, exactamente el tipo de territorio donde una inversión en infraestructura de transporte podría tener mayor impacto social.

    Un detalle importante: el mapa final solo colorea los municipios estadísticamente significativos. La significancia se estima mediante un proceso de permutaciones (aleatorización), lo que nos permite distinguir los patrones reales de los que podrían aparecer por simple azar. Todo lo que no supera esa prueba se descarta como «Sin significancia».

    En resumen, el objetivo del ejercicio no es hacer un mapa bonito, sino detectar de forma reproducible dónde coinciden espacialmente la carencia vial y la pobreza, para pasar de la intuición a la evidencia.

    2. La preparación

    Antes de correr una sola línea, conviene tener el entorno y los insumos ordenados. Este flujo se apoya por completo en R y en un puñado de librerías del ecosistema geoespacial:

    • sf para leer y manipular los datos vectoriales.
    • terra como soporte del manejo espacial.
    • tidyverse para toda la limpieza y transformación de las tablas.
    • rgeoda, la protagonista de este análisis: es la interfaz de GeoDa en R y contiene toda la maquinaria de autocorrelación espacial y estadísticos LISA.
    • ggplot2 junto con ggspatial y patchwork para la composición cartográfica.
    • cptcity y RColorBrewer para las paletas de color.

    En cuanto a los datos de entrada, necesitamos combinar dos mundos:

    • Capas vectoriales: la capa municipal que ya contiene el atributo de longitud de vías (derivada de datos de INVIAS), los límites departamentales del IGAC y una capa mundial de contexto obtenida con geodata.
    • Datos tabulares: el IPM municipal en formato CSV, tomado del Departamento Nacional de Planeación (DNP).

    El puente entre ambos es el código DANE del municipio (MPIO_CCNCT). Aquí un pequeño pero clásico dolor de cabeza: algunos códigos pierden el cero inicial al leerse (típicamente Antioquia y Atlántico), así que hay que restituir ese 0 antes de unir las tablas, o el cruce fallará silenciosamente. Por último, todas las capas se llevan a un mismo sistema de referencia (EPSG:4326) para que se alineen correctamente.

    3. Comandos clave

    Sin entrar línea por línea, estos son los comandos que sostienen todo el análisis y vale la pena entender a nivel conceptual:

    queen_weights() → Es el punto de partida. Construye la matriz de vecindad bajo el criterio de la reina (dos municipios son vecinos si comparten un borde o incluso un solo vértice). Sin una definición de «quién es vecino de quién», no existe lo espacial en la estadística espacial: esta matriz es el cimiento de todo lo demás.

    local_bimoran() → El corazón del ejercicio. Recibe la matriz de vecindad y las dos variables (vías e IPM) y calcula el Moran bivariado local para cada municipio, entregando su cuadrante y su nivel de significancia. Es la función que traduce la pregunta conceptual en un resultado cuantitativo.

    lisa_clusters(), lisa_labels() y lisa_colors() → El trío que traduce el resultado a algo interpretable. La primera asigna la categoría a cada municipio, la segunda recupera las etiquetas estándar (Alto–Alto, Bajo–Alto, etc.) y la tercera aporta la paleta canónica de GeoDa, para que el mapa hable el mismo lenguaje visual que la literatura del tema.

    inner_join() → El enlace entre lo tabular y lo geométrico. Es la operación que pega el IPM del DNP a la geometría municipal mediante el código DANE. Un cruce mal hecho aquí arruina todo el análisis, por eso la limpieza previa de los códigos es tan importante.

    annotation_scale() y annotation_north_arrow() → Los elementos que convierten un gráfico en un mapa. La barra de escala y la flecha de norte no son adornos: son lo que le permite a cualquier lector interpretar correctamente la información. Es un paso que siempre insisto en no saltarse.

    Conclusión

    El Moran bivariado es una de esas técnicas que cambian la forma de leer un territorio: pasamos de describir variables por separado a detectar cómo se relacionan en el espacio. Aplicado a las vías y al IPM, nos entrega un mapa que no solo se ve bien, sino que señala con evidencia estadística dónde la falta de conectividad y la pobreza se dan la mano en Colombia.

    Si quieres ver el paso a paso completo, con el código en pantalla y las decisiones metodológicas explicadas, te invito al vídeo en mi canal: youtube.com/fabiocastrollanos. Y si necesitas asesoría personalizada en temas de SIG y análisis espacial con R, escríbeme.

    ontacto: Fabio Castro-Llanos — wa.me/+573217850490

  • 🗺️ ¿Cómo medir la infraestructura vial a nivel municipal con R?

    Acabo de subir un nuevo video donde pasamos directo a la práctica para resolver esto. Les muestro paso a paso cómo armar el flujo de trabajo para cuantificar la infraestructura de transporte usando datos geoespaciales.

    En el tutorial vemos cómo:

    Filtrar la red vial (tipos 1 a 4) para quedarnos solo con lo importante.

    • Hacer una intersección espacial entre las vías y los municipios usando el paquete terra.
    • Automatizar el cálculo para sacar la longitud total (en kilómetros) por cada municipio.
    • Rematar con un mapa de calor para visualizar súper rápido qué zonas del país están mejor conectadas.

    Si trabajan con SIG y quieren aprender a automatizar este tipo de geoprocesos en R, el tutorial te va a gustar.

    Si me deseas contactar: wa.me/+573217850490

  • Los códigos los puedes descargar aquí:

    Si deseas asesoría me puedes escribir: wa.me/+573217850490

    Saludos

  • Contacto: wa.me/+573217850490

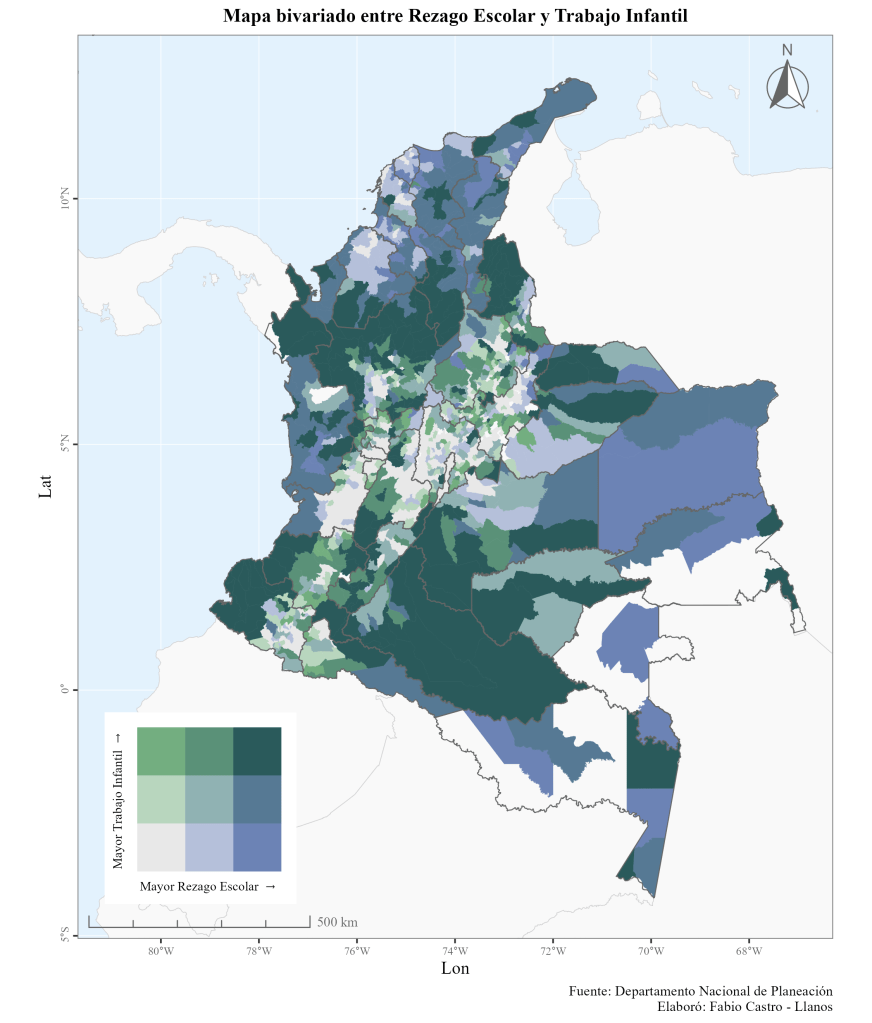
    En este vídeo tutorial explicamos cómo realizar un mapa bivariado entre las variables de rezago escolar y trabajo infantil a nivel municipal para Colombia, los datos son tomados del Departamento Nacional de Planeación de Colombia.

    En el análisis de datos geográficos, a menudo no basta con ver una sola variable en el mapa. A veces, la pregunta real es: ¿Cómo interactúan dos fenómenos en un mismo territorio? Para responder a esto, una de las herramientas más potentes y visualmente atractivas es el Mapa Bivariado. En este post, les explicaré la lógica detrás de un script desarrollado en R para analizar la relación entre el Rezago Escolar y el Trabajo Infantil.

    ¿Qué es un mapa bivariado?

    A diferencia de un mapa de coropletas tradicional (que usa una escala de un solo color), el mapa bivariado utiliza una matriz de colores. Esto nos permite identificar no solo dónde los valores son altos o bajos para una variable, sino dónde se combinan ambas situaciones.

    La lógica del proceso

    Para lograr este resultado, el flujo de trabajo se divide en tres grandes pilares:

    1. Preparación de los datos espaciales

    El primer paso consiste en cargar la información base (capas departamentales y bases de datos georeferenciadas). En este punto, es vital definir los límites geográficos (bbox) para que el mapa se centre exactamente en el área de interés, eliminando ruidos visuales innecesarios.

    2. Clasificación bivariada (El corazón del mapa)

    Aquí es donde ocurre la «magia». Utilizando la librería biscale, los datos se clasifican en grupos (generalmente terciles o cuantiles). El script toma dos variables independientes:

    • Eje X: Rezago Escolar.
    • Eje Y: Trabajo Infantil.

    El resultado es una nueva columna en nuestros datos que combina ambas dimensiones en categorías únicas (por ejemplo: «Bajo-Bajo», «Alto-Bajo», «Alto-Alto»).

    3. Composición y Diseño Cartográfico

    Un buen mapa debe ser tan informativo como estético. La lógica del diseño incluye:

    • Capas de contexto: Se añade un fondo global y los límites departamentales para dar ubicación espacial.
    • Simbolización: Se aplica una paleta de colores específica (como DkCyan) que permite diferenciar claramente los cuadrantes de la matriz.
    • Elementos técnicos: Se incorporan la flecha de norte, la escala gráfica y etiquetas precisas para que cualquier lector pueda interpretar la escala.

    El resultado final: La Leyenda

    Lo más importante en un mapa bivariado es su leyenda en forma de diamante. El script no solo genera el mapa, sino que construye una leyenda independiente que se superpone al lienzo principal. Esta matriz nos dice, por ejemplo, que las zonas en los tonos más oscuros son aquellas donde ambos problemas sociales convergen con mayor intensidad.

    Conclusión

    Visualizar datos de esta manera nos permite identificar patrones críticos de forma inmediata, facilitando la toma de decisiones basada en datos geográficos. R, a través de potentes librerías como terra, sf y ggplot2, sigue siendo la herramienta líder para este tipo de análisis avanzado.

  • El mapa que creamos en el vídeo tutorial

    Sin embargo, es posible replicarlo para cualquier ciudad del mundo, entre tanto hacemos uso de datos libres de Open Street Maps

    Contacto: wa.me/+573217850490

  • En este vídeo tutorial explico como hacer uso de la librería geoBounds dentro de R para acceder a información de shapefiles político administrativo a distintos niveles. Y podemos lograr mapas como este:

    Blog original: https://dieghernan.github.io/202602_geobounds/

    Contacto: Fabio Castro – Llanos Whatsapp: wa.me/+573217850490

  • Contacto

    Fabio Alexander Castro Llanos: fabioalexandercastro@gmail.com wa.me/+573217850490

    En este pequeño proyecto desarrollé una aplicación interactiva en R Shiny para visualizar el Palmer Drought Severity Index (PDSI) a nivel municipal en Colombia. La idea es bastante simple: poder explorar cómo cambian las condiciones de sequía o humedad mes a mes usando un mapa interactivo.

    El resultado final es una app donde el usuario puede seleccionar año y mes, y automáticamente el mapa se actualiza mostrando el valor del índice en cada municipio.

    La aplicación está construida usando sf, leaflet, tidyverse y Shiny, junto con algunos ajustes visuales usando bslib para darle una apariencia moderna

    📦 Carga de librerías y datos

    El primer paso consiste en cargar las librerías necesarias y leer los datos que vamos a usar.

    En este caso se utilizan dos datasets principales:

    • Un shapefile simplificado de los municipios de Colombia
    • Una tabla con los valores mensuales del PDSI
    require(sf)
    require(tidyverse)
    require(shiny)
    require(leaflet)
    require(bslib)
    require(RColorBrewer)
    mpio <- st_read("./www/mpios_simplify.gpkg", quiet = TRUE)
    znal <- read_csv(
    "./www/zonal_pdsi_year-monthly_gather.csv"
    ) |>
    select(MpCodigo, MpNombre, Depto, year, month, value)

    Algo importante aquí es asegurarse de que el código del municipio tenga el mismo tipo de dato en ambas tablas para poder hacer correctamente el join.

    mpio$MPIO_CCNCT <- as.character(mpio$MPIO_CCNCT)
    znal$MpCodigo <- as.character(znal$MpCodigo)
    🎛️ Interfaz de usuario (UI)

    La interfaz se construyó con Bootstrap 5 usando el paquete bslib. Esto permite aplicar temas modernos y tipografías personalizadas.

    theme = bs_theme(
    version = 5,
    bootswatch = "darkly",
    primary = "#38bdf8"
    )

    En el panel izquierdo se agregaron dos controles simples:

    • selección de año
    • selección de mes
    selectInput("yr", "Año", choices = yrs_avl)
    selectInput("mt", "Mes", choices = mth_avl)

    Estos inputs serán los que controlan la actualización del mapa.

    En el panel principal se incluye el mapa interactivo:

    leafletOutput("map_pdsi")

    Además agregué algunos detalles visuales como tarjetas (cards), tipografía moderna y enlaces a redes sociales.

    ⚡ Lógica reactiva en el servidor

    La magia de Shiny ocurre en el server, donde se construye el flujo reactivo de la aplicación.

    Primero se filtran los datos del índice según el año y el mes seleccionados:

    tbl_pdsi <- reactive({
    znal |>
    filter(
    year == input$yr,
    month == input$mt
    )
    })

    Luego se realiza la unión con el shapefile municipal:

    mpio_pdsi <- reactive({
    mpio |>
    left_join(
    tbl_pdsi(),
    by = c("MPIO_CCNCT" = "MpCodigo")
    )
    })

    De esta forma cada municipio queda asociado con su valor del índice PDSI.

    🗺️ Construcción del mapa interactivo

    Primero se inicializa el mapa base usando Leaflet:

    output$map_pdsi <- renderLeaflet({
    leaflet() %>%
    addProviderTiles(providers$CartoDB.Positron) %>%
    setView(lng = -74, lat = 4.5, zoom = 6)
    })

    Después se actualizan los polígonos dinámicamente cada vez que cambia el año o el mes.

    pal <- colorNumeric(
    palette = brewer.pal(11, "BrBG"),
    domain = dat$value
    )

    Esta paleta permite representar:

    • valores negativos → sequía
    • valores positivos → humedad

    Finalmente se dibujan los municipios en el mapa.

    addPolygons(
    fillColor = ~pal(value),
    fillOpacity = 0.8,
    label = ~paste0(MpNombre, "<br>PDSI: ", round(value,2))
    )

    Además se agrega una leyenda dinámica que ayuda a interpretar los colores.

    🌎 Resultado

    El resultado es una pequeña aplicación interactiva que permite explorar rápidamente las condiciones de sequía o humedad en Colombia a escala municipal.

    Este tipo de herramientas resulta especialmente útil para:

    • monitoreo climático
    • análisis agroclimático
    • exploración de datos espaciales en tiempo real

    Y demuestra lo poderoso que puede ser R para construir aplicaciones geoespaciales interactivas con relativamente pocas líneas de código.